Показаны сообщения с ярлыком TensorFlow Estimators. Показать все сообщения

понедельник, 12 ноября 2018 г.

TensorFlow: создание кастомных Estimators

В этом посте мы рассмотрим кастомные Estimators. В частности, продемонстрируем как создавать кастомный tf.estimator.Estimator, который имитирует поведение предсозданного Estimator tf.estimator.DNNClassifier в решении классической задачи классификации ирисов. Детали использования предсозданных Estimators для Iris задачи в этом посте.

Для загрузки и доступа к коду примеров выполните следующие команды:

git clone https://github.com/tensorflow/models/
cd models/samples/core/get_started

В этом посте мы рассмотрим custom_estimator.py. Запустить его можно простой командой:

python custom_estimator.py

При желании можно легко сранивать результаты custom_estimator.py и premade_estimator.py (который находится в этой же директории).

Предсозданные vs. кастомные Estimators

Как показано на следующей иллюстрации предсозданные Estimators - это подклассы tf.estimator.Estimator базового класса, в то время как кастомные Estimators - это инстансы tf.estimator.Estimator:

Предсозданные и кастомные Estimators - это все Estimators.


Предсозданные Estimators полностью готовы для использованиня. Иногда, однако, необходим больший контроль над поведением Estimator. Вот где приходят на помощь кастомные Estimators. Вы можете создать кастомный Estimator, выполняющий все что угодно. Если вы хотите скрытые слои, связанные в необычной манере, напишите кастомный Estimator. Если вы хотите вычислять уникальную метрику для модели, напишите кастомный Estimator. В общем, если вы хотите Estimator, оптимизированный для вашей специфичной проблемы, напишите кастомный Estimator.

Функция модели (model function) (или model_fn) реализует алгоритм машинного обучения. Единственное различие между работой предсозданных Estimators и кастомных Estimators это:

  • В предсозданных Estimators кто-то уже написал функцию модели для вас.
  • В кастомных Estimators необходимо написать функцию модели самому.

Ваша функция модели может реализовывать широкий спектр алгоритмов, определяя все виды скрытых слоев и метрик. Как и функции ввода, все функции модели должны принимать стандартную группу вводных параметров и возвращать стандартную группу значений вывода. Также как функции ввода используют механизмы Dataset API, так и функции модели используют Layers API и Metrics API.

Рассмотрим как разрешить Iris задачу с кастомным Estimator. В качестве напоминания - вот организация Iris модели, которую мы пробуем имитировать:

Наша реализация Iris содержит четыре свойства, два скрытых слоя и слой вывода.

Напишем функцию ввода

Наша кастомная реализация Estimator использует ту же функцию ввода, что и реализация предсозданного Estimator, из iris_data.py. А именно:

def train_input_fn(features, labels, batch_size):
    """Функция ввода для тренировки"""
    # Преобразуем ввод в Dataset.
    dataset = tf.data.Dataset.from_tensor_slices(
                                     (dict(features), labels))

    # Перемешиваем, повторяем, и пакетизируем примеры.
    dataset = dataset.shuffle(1000).repeat().batch(batch_size)

    # Возвращаем конец пайплайна для чтения.
    return dataset.make_one_shot_iterator().get_next()

Эта функция ввода строит пайплайн ввода, который выводит пакеты (features, labels) пар, где features - это словарные свойства.

Создаем колонки свойств

Как уже рассказывалось в предыдущих постах о Estimators, необходимо определить колонки свойств вашей модели для того, чтобы задать как модели следует использовать каждое свойство. Работаем ли мы с предсозданными или кастомными Estimators - задание колонок свойств происходит одинаковым образом.

Следующий код создает простую numeric_column для каждого вводного свойства, обозначая, что значение вводного свойства следует использовать напрямую как ввод для модели:

# Колонки свойств описывают как использовать ввод.
my_feature_columns = []
for key in train_x.keys():
    my_feature_columns.append(tf.feature_column.numeric_column(key=key))

Пишем функцию модели

Функция модели, которую мы будем использовать, имеет следующую сигнатуру вызова:

def my_model_fn(
   features, # Это batch_features из input_fn
   labels,   # Это batch_labels из input_fn
   mode,     # Инстанс tf.estimator.ModeKeys
   params):  # Дополнительная конфигурация

Первые два аргумента - это пакеты свойств и меток, возвращенные функцией ввода, то есть свойства и метки - это ручки для данных, которые будет использовать модель. mode аргумент обозначает какая операция вызывается: тренировка, обучение или прогнозирование.

Вызывающий может передать параметры к конструктору Estimstor'а. Любые параметры, переданные конструктору, в свою очередь, передаются в model_fn. В custom_estimator.py следующие строки создают estimator и устанавливают параметры для конфигурации модели. Этот шаг конфигурации схож с тем как конфигурировался tf.estimator.DNNClassifier в предсозданных Estimators.

classifier = tf.estimator.Estimator(
    model_fn=my_model_fn,
    params={
        'feature_columns': my_feature_columns,
        # Два скрытых слоя по 10 узлов каждый.
        'hidden_units': [10, 10],
        # Модель должны сделать выбор между 3 классами.
        'n_classes': 3,
    })

Для того чтобы реализовать типичную функцию модели необходимо выполнить следующее:

  • Определить модель.
  • Определить дополнительные вычисления для каждого из трех различных режимов:
    • Прогнозирование
    • Оценка
    • Тренировка

Определяем модель

Базовая модель глубокой нейронной сети должна содержать следующие три компонента:

  • Слой ввода
  • Один или больше скрытых слоев
  • Слой вывода

Определяем слой ввода

Первая строка model_fn вызывает tf.feature_column.input_layer, чтобы преобразовать словарь свойств и feature_columns во ввод для вашей модели:

# Используем input_layer для применения колонок свойств.
net = tf.feature_column.input_layer(features, params['feature_columns'])

Предыдущий код применяет преобразования, определенные колонками свойств, при создании слоя ввода модели.


Скрытые слои

Если вы создаете глубокую нейронную сеть, вы должны определить один или больше скрытых слоев. Layers API предоставляет богатый набор функций для определения всех типов скрытых слоев, включая сверточные, пуловые и дропаут слои. Для Iris мы просто собираемся вызвать tf.layers.dense, чтобы создать скрытые слои, с измерениями, определенными параметром params['hidden_layers']. В тесносвязанном (dense) слое каждый узел связан с каждым узлом в предыдущем слое.

# Строим скрытые слои, размером согласно 'hidden_units' параметру.
for units in params['hidden_units']:
    net = tf.layers.dense(net, units=units, activation=tf.nn.relu)

  • units параметр определяет количество нейронов вывода в данном слое.
  • activation параметр определяет функцию активации - Relu в данном случае.

Переменная net означает здесь текущий верхний слой сети. В ходе первой итерации net обозначает слой ввода. На каждой итерации цикла tf.layers.dense создает новый слой, который принимает вывод предыдущего слоя как свой ввод.

После создания двух скрытых слоев, сеть выглядит следующим образом. Для простоты, на изображении не показаны все элементы в каждом слое.

Следует отметить что tf.layers.dense предоставляет много дополнительных возможностей, включая возможность устанавливать множество параметров регуляризации. Для простоты, однако, мы примем дефолтные значения для параметров.

Слой вывода

Мы определим слой вывода, вызвав tf.layers.dense еще раз, на этот раз без функции активации:

logits = tf.layers.dense(net, params['n_classes'], activation=None)

Здесь net обозначает финальный слой вывода. Более того, полный набор слоев сейчас связан следующим образом:

Финальный скрытый слой передает результат в слой вывода.


При определении слоя вывода units параметр задает количество выводов. Таким образом, с установкой units равным params['n_classes'], модель производит одно значение вывода на класс. Каждый элемент вектора вывода будет содержать счет, или "logit", рассчитанный для соответствующего класса ириса: Setosa, Versicolor, или Virginica, соответственно.

Позже эти logits будут преобразованы в вероятности tf.nn.softmax функцией.

Реализуем тренировку, оценку, и прогнозирование.

Финальный шаг в создании функции модели - это написание ветвящегося кода, который реализует прогнозирование, оценку, и тренировку.

Функция модели вызывается когда кто-либо вызывает методы train, evaluate, или predict Estimator'а. Напомним, что сигнатура для функции модели выглядит следующим образом:

def my_model_fn(
   features, # Это batch_features из input_fn
   labels,   # Это batch_labels из input_fn
   mode,     # Инстанс tf.estimator.ModeKeys
   params):  # Дополнительная конфигурация

Сфокусируемся на третьем аргументе, mode. Как показывает следующая таблица, когда кто-то вызывает train, evaluate, или predict, Estimator вызывает функцию модели с mode параметром, установленным следующим образом:

Например, предположим вы создали кастомный Estimator, чтобы сгенерировать объект, названный classifier.

classifier = tf.estimator.Estimator(...)
classifier.train(input_fn=lambda: my_input_fn(FILE_TRAIN, True, 500))

Estimator затем вызывает функцию модели с аргументом mode установленный в ModeKeys.TRAIN.

Ваша функция модели должна предоставить код, чтобы обрабатывать все три mode значения. Для каждого mode значения, код должен возвращать инстанс tf.estimator.EstimatorSpec, который содержит информацию, необходимую вызывающему. Рассмотрим каждый mode.

Predict mode (Прогнозирование)

Когда вызывается predict метод Estimator'а, model_fn получает mode = ModeKeys.PREDICT. В этом случае, функция модели должна вернуть tf.estimator.EstimatorSpec, содержащий прогноз.

Модель должна быть натренирована перед проведением прогнозирования. Тренированная модель сохраняется на диск в model_dir директории, установленной при создании инстанса Estimator.

Код для генерации прогноза для этой модели выглядит следующим образом:

# Вычисляем прогнозы.
predicted_classes = tf.argmax(logits, 1)
if mode == tf.estimator.ModeKeys.PREDICT:
    predictions = {
        'class_ids': predicted_classes[:, tf.newaxis],
        'probabilities': tf.nn.softmax(logits),
        'logits': logits,
    }
    return tf.estimator.EstimatorSpec(mode, predictions=predictions)

Словарь predictions содержит все, что модель возвращает, когды выполняется в predict mode.

predictions содержит следующие три ключ/значение пары:

  • class_ids содержит идентификаторы классов (0, 1, или 2), представляющие прогноз модели наиболее вероятного вида ирисов для этого примера.
  • probabilities содержит три вероятности (в этом примере, 0.02, 0.95, и 0.03)
  • logit содержит сырые logit значения (в этом примере, -1.3, 2.6, и -0.9)

Мы возвращаем этот словарь вызывающему через predictions параметр tf.estimator.EstimatorSpec. Метод tf.estimator.Estimator.predict будет выводить этот словарь.

Рассчет потери

Для обоих случаев - тренировки и оценки - нам необходимо рассчитать потерю модели. Это целевое значение, которое мы будем оптимизировать в ходе тренировки и оценки.

Мы можем рассчитать потерю, вызвав tf.losses.sparse_softmax_cross_entropy. Значение, возвращенное этой функцией будет приближаться к нулю, когда вероятность правильного класса (в индекс метке) будет равна почти 1.0. Возвращаемое значение потери будет прогрессивно расти с уменьшением вероятности правильного класса.

Эта функция возвращает среднее значение для целого пакета.

# Вычисляем потерю.
loss = tf.losses.sparse_softmax_cross_entropy(labels=labels, 
                                              logits=logits)

Evaluate mode (Оценка)

Когда вызывается evaluate метод Estimator'а, model_fn получает mode = ModeKeys.EVAL. В этом случае, функция модели должна вернуть tf.estimator.EstimatorSpec, содержащий потерю модели и опционально одну или несколько метрик.

Хотя возвращение метрик опционально, большинство кастомных Estimators возвращают по крайней мере одну метрику. TensorFlow предоставляет Metrics модуль tf.metrics для вычисления общих метрик. В целях краткости, мы будем возвращать только аккуратность. tf.metrics.accuracy функция сравнивает наши прогнозы с настоящими значениями, то есть, с метками, предоставленными вводной функцией. tf.metrics.accuracy функция требует, чтобы метки и прогнозы имели одинаковую форму. Вот вызов tf.metrics.accuracy:

# Вычисляем оценку метрик.
accuracy = tf.metrics.accuracy(labels=labels,
                               predictions=predicted_classes,
                               name='acc_op')

tf.estimator.EstimatorSpec возвращенный для оценки обычно содержит следующую информацию:

  • loss - потеря модели
  • eval_metric_ops - опциональный словарь метрик

Таким образом, мы будем создавать словарь, содержащий единственную метрику. Если бы мы рассчитали другие метрики, мы бы добавили их как дополнительные ключ/значение пары к этому же словарю. Затем, мы передадим этот словарь в eval_metric_ops аргумент tf.estimator.EstimatorSpec.

metrics = {'accuracy': accuracy}
tf.summary.scalar('accuracy', accuracy[1])

if mode == tf.estimator.ModeKeys.EVAL:
    return tf.estimator.EstimatorSpec(
        mode, loss=loss, eval_metric_ops=metrics)

tf.summary.scalar сделает аккуратность доступной для TensorBoard в обоих TRAIN и EVAL режимах(modes).

Train mode (Тренировка)

Когда вызывается train метод Estimator'а, model_fn получает mode = ModeKeys.TRAIN. В этом случае, функция модели должна вернуть tf.estimator.EstimatorSpec, содержащий потерю и тренировочную операцию.

Построение тренировочной операции потребует оптимизатор. Мы будем использовать tf.train.AdagradOptimizer, потому что мы имитируем DNNClassifier, который также использует Adagrad по умолчанию. tf.train пакет также предоставляет много других оптимизаторов.

Вот код, который создает оптимизатор:

optimizer = tf.train.AdagradOptimizer(learning_rate=0.1)

Далее мы построим тренировочную операцию, используя метод tf.train.Optimizer.minimize оптимизатора на потере, которую мы рассчитали ранее.

minimize метод принимает global_step параметр. TensorFlow использует этот параметр для счета количества произведенных тренировочных шагов (для того чтобы знать когда тренировка должна остановиться). Более того global_step необходим для корректной работы TensorBoard графов. Просто вызываем tf.train.get_global_step и передаем результат как global_step аргумент minimize метода.

Вот код тренировки модели:

train_op = optimizer.minimize(loss, 
                              global_step=tf.train.get_global_step())

tf.estimator.EstimatorSpec возвращаемый для тренировки должен иметь следующий набор полей:

  • loss, содержащее значение потери модели.
  • train_op, которое исполняет тренировочный шаг.

Вот код для вызова EstimatorSpec:

return tf.estimator.EstimatorSpec(mode, loss=loss, train_op=train_op)

Кастомный Estimator

Создадим инстанс кастомного Estimator'а через базовый Estimator класс:

# Строим 2 скрытых слоя с 10 узлами в каждом.
classifier = tf.estimator.Estimator(
    model_fn=my_model_fn,
    params={
       'feature_columns': my_feature_columns,
       # 2 скрытых слоя с 10 узлами в каждом
       'hidden_units': [10, 10],
       # Модель должна выбирать между 3 классами.
       'n_classes': 3,
    })

Здесь params словарь служит той же цели, что и key-word аргументы DNNClassifier; то есть, params словарь позволяет конфигурировать Estimator без изменения кода в model_fn.

Остальной код для тренировки, оценки и выполнения прогнозов такой же как и в предсозданных Estimators. Например, следующий код будет тренировать модель:

# Тренируем модель
classifier.train(
    input_fn=lambda:iris_data.train_input_fn(train_x, 
                                             train_y, 
                                             args.batch_size),
    steps=args.train_steps)


TensorBoard

Вы можете просматривать результаты тренировки для кастомного Estimator'а в TensorBoard. Для того чтобы увидеть результаты, запустите TensorBoard из командной строки следующим образом:

# Замените PATH настоящим путем, переданным как model_dir
tensorboard --logdir=PATH

Затем откройте TensorBoard в браузере по адресу http://localhost:6006

Все предсозданные Estimators автоматически логируют множество информации в TensorBoard. С кастомными Estimators, однако, TensorBoard предоставляет только один лог по умолчанию (граф потери) плюс информацию, которую вы явно передадите на логирование в TensorBoard. Для кастомного Estimator, который мы только что создали, TensorBoard генерирует следующее:

TensorBoard показывает три графа.

Вкратце, вот что эти три графа говорят вам:

  • global_step/sec: Индикатор производительности, показывающий как много пакетов (градиентных апдейтов) мы обработали за секунду в ходе тренировки модели.
  • loss: отчет о потере.
  • accuracy: Аккуратность записанная следующими двумя строками:
    • eval_metric_ops={'my_accuracy': accuracy}, в ходе оценки.
    • tf.summary.scalar('accuracy', accuracy[1]), в ходе тренировки.

Эти TensorBoard графы - одна из главных причин, по которой важно передавать аргумент global_step в метод minimize оптимизатора. Модель не может записывать x-координаты для этих графов без этого аргумента.

Отметим следующее в my_accuracy и loss графах:

  • Оранжевая линия представляет тренировку.
  • Синяя точка представляет оценку.

В ходе тренировки заключения (оранжевая линия) записаны периодично с ходом обработки пакетов, которые поэтому становятся графом растянутым по x-оси.

В противоположность этому, оценка производит только единственную точку на графе для каждого вызова оценки. Эта точка содержит среднее значение за весь вызов оценки. Эта точка не имеет ширины на графе, потому что оценка происходит целиком по состоянию модели в отдельный шаг тренировки (из единственной точки).

Как изображено на следующей иллюстрации вы можете отдельно включать/выключать отчет, используя управление с левой стороны TensorBoard.


Резюме

Хотя предсозданные Estimators могут быть эффективным путем для быстрого создания новых моделей, часто требуется дополнительная гибкость, которую предоставляют кастомные Estimators. К счастью, предсозданные и кастомные Estimators следуют одной и той же программной модели. Единственное практическое различие в том, что вы должны написать функцию модели для кастомных Estimators; остальное все тоже самое.

четверг, 1 ноября 2018 г.

TensorFlow: Datasets для Estimators

tf.data модуль содержит коллекцию классов, которые позволяют легко загружать данные, манипулировать ими, и направлять их в модель. В этом посте мы рассмотрим два простых примера:

  • Чтение данных в память из numpy массивов.
  • Чтение строк из csv файла.

Базовый ввод

Взятие частей данных из массива - это самый простой способ начать использовать tf.data.

В предыдущих постах была описана следующая train_input_fn функция, из iris_data.py, передающая данные в Estimator:

def train_input_fn(features, labels, batch_size):
    """Функция ввода для тренировки"""
    # Преобразуем ввод в Dataset.
    dataset = tf.data.Dataset.from_tensor_slices(
                                   (dict(features), labels))

    # Перемешиваем, повторяем, и пакетизируем примеры.
    dataset = dataset.shuffle(1000).repeat().batch(batch_size)

    # Возвращаем dataset.
    return dataset

Рассмотрим подробней.

Аргументы

Эта функция предполагает три аргумента. Аргументы ожидаются "массивами", но могут принимать почти все что угодно, что может быть преобразовано к массиву с использованием numpy.array. Единственное исключение - это tuple, который имеет специальное значение для Datasets.

  • features: {'feature_name':array} словарь (или DataFrame), содержащий сырые вводные свойства.
  • labels: массив, содержащий метку для каждого примера.
  • batch_size: число, обозначающее желаемый размер пакета.

В premade_estimator.py мы извлекаем Iris данные, используя iris_data.load_data() функцию.

import iris_data

# Извлекаем данные 
train, test = iris_data.load_data()
features, labels = train

Затем мы передаем эти данные функции ввода:

batch_size=100
iris_data.train_input_fn(features, labels, batch_size)

Рассмотрим train_input_fn().

Части (slices)

Функция начинается использованием tf.data.Dataset.from_tensor_slices функции для создания tf.data.Dataset, представляющего части массива. Массив разделен на части по первому измерению. Например, массив содержит MNIST тренировочные данные, имеющие форму (60000, 28, 28). Передав его from_tensor_slices получим Dataset объект, содержащий 60000 частей, каждый из которых изображение 28x28.

train, test = tf.keras.datasets.mnist.load_data()
mnist_x, mnist_y = train

mnist_ds = tf.data.Dataset.from_tensor_slices(mnist_x)
print(mnist_ds)

Это распечатает следующий вывод, показывающий формы и типы элементов в датасете. Следует отметить, что Dataset не знает сколько элементов он содержит.

<TensorSliceDataset shapes: (28,28), types: tf.uint8>

Dataset выше представляет простую коллекцию массивов, но датасеты способны на большее, чем это. Dataset может обрабатывать любые вложенные комбинации словарей или таплов (tuples) (или namedtuple).

Например, после преобразования свойств ирисов к стандартному Python словарю, можно конвертировать словарь массивов в Dataset словарей следующим образом:

dataset = tf.data.Dataset.from_tensor_slices(dict(features))
print(dataset)

<TensorSliceDataset

  shapes: {
    SepalLength: (), PetalWidth: (),
    PetalLength: (), SepalWidth: ()},

  types: {
      SepalLength: tf.float64, PetalWidth: tf.float64,
      PetalLength: tf.float64, SepalWidth: tf.float64}
>

Здесь мы видим, что, когда Dataset содержит структурированные элементы, формы и типы Dataset берет той же структуры. Этот датасет содержит словари скаляров, все типа tf.float64.

Первая строка iris train_input_fn использует ту же функциональность, но добавляет другой уровень структуры. Она создает датасет, содержащий (features_dict, label) пары.

Следующий код показывает, что метка - это скаляр с типом int64.

# Преобразуем ввод в Dataset.
dataset = tf.data.Dataset.from_tensor_slices((dict(features), labels))
print(dataset)

<TensorSliceDataset
    shapes: (
        {
          SepalLength: (), PetalWidth: (),
          PetalLength: (), SepalWidth: ()},
        ()),

    types: (
        {
          SepalLength: tf.float64, PetalWidth: tf.float64,
          PetalLength: tf.float64, SepalWidth: tf.float64},
        tf.int64)>

Манипуляция

На текущий момент Dataset будет проходить данные только единожды, в фиксированном порядке, и произведет только один элемент за раз. Требуется дальнейшая обработка перед использованием в тренировке. К счастью, tf.data.Dataset класс предоставляет методы для более качественной обработки данных перед тренировкой. Следующий код функции ввода использует преимущество использования нескольких из этих методов:

# Перемешиваем, повторяем, и пакетизируем примеры.
dataset = dataset.shuffle(1000).repeat().batch(batch_size)

tf.data.Dataset.shuffle метод использует буфер фиксированного размера для перемешивания элементов, в то время как они проходят через метод. В этом случае buffer_size больше, чем количество примеров в Dataset.

tf.data.Dataset.repeat метод рестартует Dataset, когда он достигает конца. Для ограничения количества эпох, задавайте count аргумент.

tf.data.Dataset.batch метод собирает ряд примеров и складывает их друг на друга для создания пакетов. Это добавляет измерение к их форме. Новое измерение добавляется как первое измерение. Следующий код использует batch метод на MNIST Dataset. В результате получается Dataset, содержащий 3D массивы, представляющие стеки (28,28) изображений:

print(mnist_ds.batch(100))

<BatchDataset
  shapes: (?, 28, 28),
  types: tf.uint8>

Отметим, что датасет имеет неизвестный размер пакета, потому что последний пакет будет иметь меньше элементов.

В train_input_fn, после пакетизации Dataset содержит 1D вектора элементов, где ранее были скаляры:

print(dataset)

<TensorSliceDataset
    shapes: (
        {
          SepalLength: (?,), PetalWidth: (?,),
          PetalLength: (?,), SepalWidth: (?,)},
        (?,)),

    types: (
        {
          SepalLength: tf.float64, PetalWidth: tf.float64,
          PetalLength: tf.float64, SepalWidth: tf.float64},
        tf.int64)>

Вывод (return)

В этой точке Dataset содержит (features_dict, labels) пары. Это формат, ожидаемый train и evaluate методами, таким образом input_fn возвращает датасет.

Метки могут/должны быть пропущены при использовании predict метода.


Чтение CSV файла

Наиболее распространенный способ применения Dataset класса - это создание потока данных с файлов на диске. tf.data включает различные функции чтения файлов. Рассмотрим получение Iris датасета из csv файла с использованием Dataset.

Следующий вызов iris_data.maybe_download функции загружает данные если необходимо и возвращает путь результирующих файлов:

import iris_data
train_path, test_path = iris_data.maybe_download()

iris_data.csv_input_fn функция содержит альтернативную реализацию, которая обрабатывает csv файлы, используя Dataset.

Рассмотрим как построить совместимую с Estimator функцию ввода, которая производит чтение с локальных файлов.

Строим Dataset

Мы начнем с построения tf.data.TextLineDataset объекта для чтения файла по одной строке за раз. Затем мы вызываем tf.data.Dataset.skip метод, чтобы пропустить первую строку файла, которая содержит заголовок, а не пример:

ds = tf.data.TextLineDataset(train_path).skip(1)

Строим парсер csv файла

Мы начнем с построения функции для парсинга одной строки.

Следующая функция iris_data.parse_line выполняет такую задачу, используя tf.decode_csv функцию, и немного python кода.

Мы должны парсить каждую строку в датасете для того, чтобы сгенерировать необходимые (свойства, метка)(features, label) пары. Следующая _parse_line функция вызывает tf.decode_csv, чтобы разбирать одну строку на ее свойства и метку. Ввиду того, что Estimators требуют, чтобы свойства были представлены как словарь, мы полагаемся на Python dict и zip функции для построения этого словаря. Имена свойств - это ключи этого словаря. Затем мы вызываем pop метод словаря, чтобы удалить поле метки из словаря свойств:

# Метеданные, описывающие текстовые колонки
COLUMNS = ['SepalLength', 'SepalWidth',
           'PetalLength', 'PetalWidth',
           'label']
FIELD_DEFAULTS = [[0.0], [0.0], [0.0], [0.0], [0]]
def _parse_line(line):
    # Декодируем строку в ее поля 
    fields = tf.decode_csv(line, FIELD_DEFAULTS)

    # Упаковываем результат в словарь
    features = dict(zip(COLUMNS,fields))

    # Отделяем метку от свойств
    label = features.pop('label')

    return features, label

Разбираем строки

Datasets имеет много методов для манипулирования данными во время прохождения их к модели. Наиболее используемый метод - это tf.data.Dataset.map, который применяет трансформацию к каждому элементу в Dataset.

map метод принимает map_func аргумент, который описывает как каждый элемент в Dataset должен быть трансформирован.

tf.data.Dataset.map метод применяет `map_func` для трансформации каждого элемента в Dataset.

Таким образом, при разборе строки идут потоком из csv файла, мы передаем нашу _parse_line функцию map методу:

ds = ds.map(_parse_line)
print(ds)

<MapDataset
shapes: (
    {SepalLength: (), PetalWidth: (), ...},
    ()),
types: (
    {SepalLength: tf.float32, PetalWidth: tf.float32, ...},
    tf.int32)>

Теперь вместо простых скалярных строк датасет содержит (features, label) пары.

Попробуйте это

Эта функция может быть использована как замещение для iris_data.train_input_fn. Она может быть использована для наполнения estimator'а:

train_path, test_path = iris_data.maybe_download()

# Все вводы - числовые
feature_columns = [
    tf.feature_column.numeric_column(name)
    for name in iris_data.CSV_COLUMN_NAMES[:-1]]

# Строим estimator
est = tf.estimator.LinearClassifier(feature_columns,
                                    n_classes=3)
# Тренируем estimator
batch_size = 100
est.train(
    steps=1000,
    input_fn=lambda : iris_data.csv_input_fn(train_path, batch_size))

Estimators ожидают, что input_fn не имеет аргументов. Для того чтобы обойти это ограничение используем lambda, чтобы захватить аргументы и предоставить ожидаемый интерфейс.

Заключение

tf.data модуль предоставляет коллекцию классов и функций для простого чтения данных из различных источников. Более того, tf.data имеет простые и удобные методы для применения широкого спектра стандартных и кастомных преобразований.

среда, 31 октября 2018 г.

TensorFlow Estimators: колонки свойств (feature columns)

В этом посте мы рассмотрим детали колонок свойств (feature columns). Колонки свойств можно рассматривать как промежуточное звено между сырыми данными и Estimators. Колонки свойств имеют обширную функциональность и позволяют преобразовывать большой список различных сырых данных в форматы, которые могут использовать Estimators, предоставляя таким образом простор для экспериментов.

Среди предсозданных Estimators мы будем использовать tf.estimator.DNNClassifier для тренировки модели прогнозировать различные виды цветов ириса по четырем вводным свойствам. В этом примере создаются только числовые колонки свойств (тип tf.feature_column.numeric_column). Хотя числовые колонки свойств модели измеряют лепестки и чашелистики эффективно, в реальных данных наборы содержат все виды свойств, многие из которых нечисловые.

Некоторые свойства из реальных данных числовые (такие как, долгота), но многие нет.


Ввод в глубокую нейронную сеть

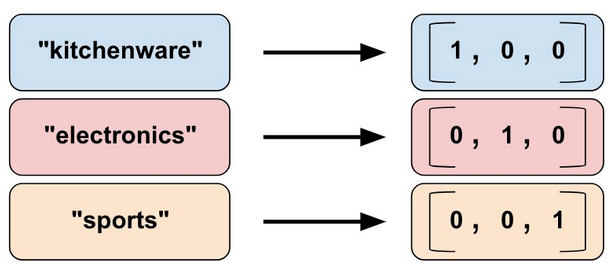
На каком типе данных может оперировать глубокая нейронная сеть? Ответ - числа (например, tf.float32). Каждый нейрон в нейронной сети выполняет операции умножения и сложения с весами и вводными данными. Вводные данные из реальной жизни, однако, часто содержат нечисловые (категориальные) значения. Например, предположим свойство product_class, который может содержать следующие три нечисловые значения:

  • kitchenware
  • electronics
  • sports

Модели машинного обучения в основном представляют категориальные значения как простые вектора, в которых 1 представляет присутствие значения, а 0 означает отсуствие значения. Например, когда product_class установлен в sports, модель машинного обучения представляет product_class как [0, 0, 1], что означает:

  • 0: kitchenware
  • 0: electronics
  • 1: sports

Таким образом, хотя сырые данные могут быть числовыми или категориальными, модель машинного обучения представляет все свойства как числа.

Колонки свойств (Feature Columns)

Как показано на следующем графике, ввод данных в модель определяется через feature_columns аргумент Estimator'а (DNNClassifier для ирисов). Колонки свойств (feature columns) - это мост между вводными данными (которые возвращает input_fn) и моделью.

Колонки свойств создают мост между сырыми данными и данными, которые требуются модели.


Для создания колонок свойств необходимо вызвать функции из tf.feature_column модуля. В этом посте мы затронем 9 функций из этого модуля. Как показано на следующей иллюстрации, все 9 функций возвращают либо Categorical Column, либо Dense Column объект, исключая bucketized_column, который наследуется из обоих этих классов:

Методы колонок свойств делятся на две категории и одну гибридную категорию.


Рассмотрим эти функции более детально.

Числовая колонка

Классификатор ирисов вызывает tf.feature_column.numeric_column функцию для всех вводных свойств:

  • SepalLength
  • SepalWidth
  • PetalLength
  • PetalWidth

Хотя для tf.numeric_column доступны опциональные аргументы, вызов tf.numeric_column без аргументов, как показано ниже, это отличный способ определить числовое значение с типом данных по умолчанию (tf.float32) как ввод для модели:

# По умолчанию tf.float32 scalar.
numeric_feature_column = tf.feature_column.numeric_column(
                                             key="SepalLength")

Чтобы определить числовой тип данных не по умолчанию, используйте dtype аргумент. Например:

# Предаставляет tf.float64 scalar.
numeric_feature_column = tf.feature_column.numeric_column(
                                              key="SepalLength",
                                              dtype=tf.float64)

По умолчанию числовая колонка создает единственное значение (скаляр). Используйте shape аргумент, чтобы определить другую форму. Например:

# Представляем 10-элементный вектор, 
# в котором каждая ячейка содержит tf.float32.
vector_feature_column = tf.feature_column.numeric_column(key="Bowling",
                                                         shape=10)

# Представляем 10x5 матрицу, в которой каждая ячейка содержит tf.float32
matrix_feature_column = tf.feature_column.numeric_column(key="MyMatrix",
                                                         shape=[10,5])


Пакетная колонка (Bucketized column)

Часто нет желания отправлять отдельное число напрямую в модель, вместо этого можно использовать пакетизацию и разделить значения на различные категории на основе числовых диапазонов. Чтобы выполнить это, создайте tf.feature_column.bucketized_column. Например, предположим сырые данные, представляющие год, в котором был построен дом. Вместо представления этого года как отдельной числовой колонки, разделим года на следующие четыре пакета:

Разделение данных по годам на четыре пакета.


Модель будет представлять пакеты следующим образом:

Почему мы разделили числа на категориальные значения, хотя простое число - это абсолютно валидный ввод для модели? Отметим, что категоризация разделяет единственное вводное число в четырехэлементный вектор. Поэтому модель теперь может обучаться четырем индивидуальным весам, а не просто одному. Четыре веса создают более богатую модель, чем один вес. Что более важно, пакетизация позволяет модели четко разделять различные годовые категории, даже если задан только один элемент, а остальные пустые. Например, когда мы используем просто единичное число как ввод, линейная модель может обучиться только линейным отношениям. Пакетизация предоставляет модели дополнительную гибкость, которую модель может использовать при обучении.

Следующий код демонстрирует как создать пакетизированное свойство:

# Во-первых, конвертируем сырой ввод в числовую колонку.
numeric_feature_column = tf.feature_column.numeric_column("Year")

# Затем пакетизируем числовую колонку по годам 1960, 1980, и 2000.
bucketized_feature_column = tf.feature_column.bucketized_column(
    source_column = numeric_feature_column,
    boundaries = [1960, 1980, 2000])

Отметим, что определение вектора по границам из трех элементов создает четырех-элементный пакетизированный вектор.


Категориальная индивидуальная колонка (Categorical identity column)

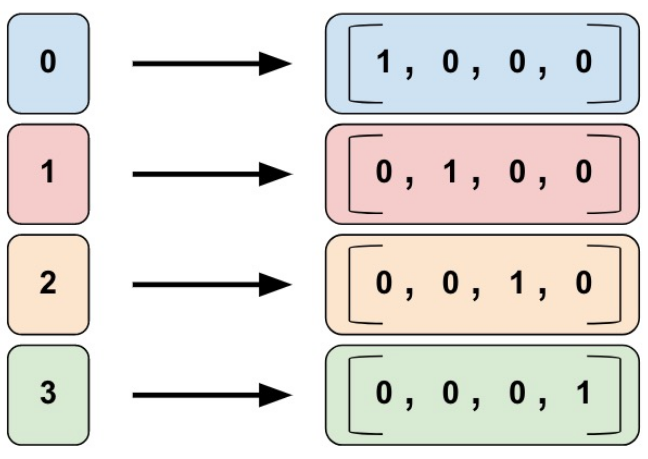
Категориальные индивидуальные колонки могут быть рассмотрены как специальный случай пакетизированных колонок. В традиционных пакетизированных колонках каждый пакет представляет диапазон значений (например, от 1960 до 1979). В категриальной индивидуальной колонке каждый пакет представляет единственное уникальное целое число. Например, представим числовой диапазон [0,4]. То есть представим числа 0, 1, 2, или 3. В этом случае, категориальное индивидуальное картирование выглядит следующим образом:

Картирование категориальной индивидуальной колонки. Следует отметить, что это одноразовое кодирование, не бинарное числовое кодирование.


Как и с пакетизированными клонками, модель может обучаться отдельному весу для каждого класса в категориальной индивидуальной колонке. Например, вместо использования строки для представления product_class, представим каждый класс уникальным числовым значением.

  • 0="kitchenware"
  • 1="electronics"
  • 2="sport"

Вызываем tf.feature_column.categorical_column_with_identity для создания категориальной индивидуальной колонки. Например:

# Создаем категориальный вывод 
# для числового свойства с именем "my_feature_b",
# значения my_feature_b должны быть >= 0 и < num_buckets
identity_feature_column = \
    tf.feature_column.categorical_column_with_identity(
        key='my_feature_b',
        num_buckets=4) # Значения [0, 4]

# Для того чтобы предыдущий вызов заработал, 
# input_fn() должна возвращать словарь, 
# содержащий 'my_feature_b' в качестве ключа. Более того, значения,
# присвоенные к 'my_feature_b', должны быть от 0 до 4.
def input_fn():
    ...
    return ({ 'my_feature_a':[7, 9, 5, 2], 
              'my_feature_b':[3, 1, 2, 2] },
            [Label_values])


Категориальная словарная колонка (Categorical vocabulary column)

Мы не можем вводить строки напрямую в модель. Вместо этого, сначала мы должны картировать строки на числовые или категориальные значения. Категориальные словарные колонки предоставляют удобный способ представить строку как одноразовый вектор. Например:

Картирование строковых значений в словарные колонки.


Как видно, категориальные словарные колонки - это enum версия категориальных индивидуальных колонок. TensorFlow предоставляет две функции для создания категориальных словарных колонок:

  • tf.feature_column.categorical_column_with_vocabulary_list
  • tf.feature_column.categorical_column_with_vocabulary_file

categorical_column_with_vocabulary_list картирует каждую строку к числу, основываясь на явно заданном словарном списке. Например:

# Дан ввод "feature_name_from_input_fn" являющийся строкой,
# создаем категориальное свойство, картируя ввод
# к одному из элементов в словарном списке.
vocabulary_feature_column =
    tf.feature_column.categorical_column_with_vocabulary_list(
        key=feature_name_from_input_fn,
        vocabulary_list=["kitchenware", "electronics", "sports"])

Предыдущая функция простая и ясная, но имеет значительный недостаток. А именно, необходимо слишком много печатать, когда словарный лист достаточно длинный. Для этих случаев вызываем метод tf.feature_column.categorical_column_with_vocabulary_file, который позволяет размещать словарные слова в отдельном файле. Например:

# Дан ввод "feature_name_from_input_fn" являющийся строкой,
# создаем категориальное свойство для нашей модели, картируя ввод
# к одному из элементов в словарном файле
vocabulary_feature_column =
    tf.feature_column.categorical_column_with_vocabulary_file(
        key=feature_name_from_input_fn,
        vocabulary_file="product_class.txt",
        vocabulary_size=3)

product_class.txt должен содержать по одной строке для каждого словарного элемента. В нашем случае:

kitchenware
electronics
sports


Хэшированная колонка (Hashed Column)

До сих пор мы работали с очень малым количеством категорий. Например, наш product_class пример имеет всего лишь 3 категории. Однако, зачастую количество категорий может быть настолько большим, что невозможно иметь индивидуальные категории для каждого словарного слова или числа, посколько это потребует слишком большого количества памяти. Для этих случаев можно взглянуть на проблему с другой стороны и задать себе вопрос: "Сколько категорий мне необходимо для моего ввода?" На деле tf.feature_column.categorical_column_with_hash_bucket функция позволяет определить такое количество категорий. Для этого типа колонки свойств модель высчитывает значение хэша для ввода и затем складывает его в одну из hash_bucket_size категорий, используя modulo оператор, как в следующем псевдокоде:

# pseudocode
feature_id = hash(raw_feature) % hash_bucket_size

Код создания feature_column может выглядеть следующим образом:

hashed_feature_column =
    tf.feature_column.categorical_column_with_hash_bucket(
        key = "some_feature",
        hash_bucket_size = 100) # количество категорий

Мы переводим различные значения ввода в меньший набор категорий. Это означает, что два вероятно не связанных ввода будут картированы к одной и той же категории, и следовательно означать одну и ту же категорию в нейронной сети. Следующая иллюстрация показывает такую ситуацию, kitchenware и sports оба назначены к категории 12 (хэш пакет):

Представление данных с хэш пакетами.


Как и с многими непонятными феноменами в машинном обучении, оказывается, что хэширование часто хорошо работает на практике. Это потому что хэш категории предоставляют модели некоторое разделение. Модель может использовать дополнительные свойства для дальнейшего разделения kitchenware от sports.


Пересеченная колонка (Crossed column)

Комбинирование свойств в единственное свойство, известное как пересечение свойств (feature cross), позволяет модели обучаться отдельным весам для каждой комбинации свойств.

Конкретней, предположим мы хотим, чтобы наша модель вычисляла цены на недвижимость в Атланте. Цены на недвижимость в рамках города значительно различаются в зависимости от расположения. Представление широты и долготы отдельными свойствами не очень удобно для определения зависимости от расположения, однако, пересечение широты и долготы в единое свойство может указать расположение. Предположим мы представим Атланту как решетку из 100x100 квадратных участков, определяя каждый из 10000 участков пересечением свойств широты и долготы. Это пересечение свойств позволит модели тренироваться на ценовых условиях, относящихся к каждому участку, что является намного более эффективным методом, чем широта и долгота по отдельности.

Следующая иллюстрация показывает план, с значениями широты и долготы по углам города:

Карта Атланты. Представим эту карту, разделенной на 10000 участков одинакового размера.


Для решения, мы используем комбинацию bucketized_column, которую мы рассматривали выше, и tf.feature_column.crossed_column функции.

def make_dataset(latitude, longitude, labels):
    assert latitude.shape == longitude.shape == labels.shape

    features = {'latitude': latitude.flatten(),
                'longitude': longitude.flatten()}
    labels=labels.flatten()

    return tf.data.Dataset.from_tensor_slices((features, labels))


# Пакетизируем широту и долготу, используя 'края'
latitude_bucket_fc = tf.feature_column.bucketized_column(
    tf.feature_column.numeric_column('latitude'),
    list(atlanta.latitude.edges))

longitude_bucket_fc = tf.feature_column.bucketized_column(
    tf.feature_column.numeric_column('longitude'),
    list(atlanta.longitude.edges))

# Создаем пересечения пакетизированных колонок, 
# используя 5000 хэш ящиков.
crossed_lat_lon_fc = tf.feature_column.crossed_column(
    [latitude_bucket_fc, longitude_bucket_fc], 5000)

fc = [
    latitude_bucket_fc,
    longitude_bucket_fc,
    crossed_lat_lon_fc]

# Создаем и тренируем Estimator.
est = tf.estimator.LinearRegressor(fc, ...)

Мы можем создавать пересечения свойств по любому из следующего:

  • Имена свойств; то есть имена из dict, возвращаемого из input_fn.
  • Любая категориальная колонка, исключая categorical_column_with_hash_bucket (ввиду того что crossed_column хэширует ввод).

Когда колонки свойств latitude_bucket_fc и longitude_bucket_fc пересечены, TensorFlow создаст (latitude_fc, longitude_fc) пары для каждого примера. Это произведет полную таблицу возможных вариантов, как следующее:

(0,0),  (0,1)...  (0,99)
 (1,0),  (1,1)...  (1,99)
   ...     ...       ...
(99,0), (99,1)...(99, 99)

За исключением случая, что полная таблица будет доступна только для вводов с ограниченными словарями. Вместо построения такой, потенциально большой таблицы вводов, crossed_column создает только количество, запрашиваемое hash_bucket_size аргументом. Колонка свойств назначает пример к индексу, выполняя хэш функцию на тапле вводов, следуемой операцией деления по модулю с hash_bucket_size.

Как обсуждалось ранее, выполнение хэш и модуль функций ограничивает количество категорий, но может вызвать коллизии категорий, то есть, несколько (широта, долгота) пересений свойств окажутся в одинаковом хэш ящике. На практике однако, выполнение пересечений свойств все равно дает значительную прибавку к обучаемой емкости модели.

Хотя это не очевидно, но при создании пересечений свойств, все равно требуется включать изначальные (непересеченные) свойства в модель (как в предыдущем отрезке кода). Независимые свойства широты и долготы помогают модели различать примеры, когда хэш коллизии случаются в пересечениях свойств.

Индикаторные и встроенные колонки (Indicator and embedding columns)

Индикаторные колонки и встроенные колонки никогда не работают на свойствах напрямую, но вместо этого принимают категориальные колонки как ввод.

Когда мы используем индикаторную колонку, мы говорим TensorFlow выполнять то, что мы видели в категориальном product_class примере. То есть, индикаторная колонка оценивает каждую категорию как элемент в одноразовом векторе, где соотвествующая категория имеет значение 1, а остальные имеют значение 0:

Представление данных в индикаторных колонках.


Вот как создавать индикаторную колонку, вызывая tf.feature_column.indicator_column:

categorical_column = ... # Создаем любой вид категориальной колонки.

# Представляем категориальную колонку как индикаторную колонку
indicator_column = tf.feature_column.indicator_column(
                                          categorical_column)

Теперь предположим, что мы имеем не просто три возможных класса, а миллион возможных классов. Или миллиард. По ряду причин с ростом количества категорий становится невозможно тренировать нейронную сеть, используя индикаторные колонки.

Мы можем использовать встроенную колонку, чтобы обойти это ограничение. Вместо представления данных одноразовым вектором с многими измерениями встроенная колонка представляет данные как малоразмерный обыкновенный вектор, в котором каждое ячейка может содержать любое число, а не только 0 или 1. Разрешая большее разнообразие чисел для каждой ячейки, встроенная колонка содержит намного меньше ячеек, чем индикаторная колонка.

Взглянем на пример, сравнивающий индикаторные и встроенные колонки. Предположим вводные примеры состоят из различных слов из ограниченного набора 81 слова. Далее предположим, что набор данных предоставляет следующие вводные слова в 4 отдельных примерах:

  • "dog"
  • "spoon"
  • "scissors"
  • "guitar"

В этом случае следующая иллюстрация показывает путь обработки для встроенных колонок или индикаторных колонок.

Встроенная колонка сохраняет категориальные данные в векторе с меньшим количеством измерений, чем индикаторная колонка. (Мы просто разместим случайные числа в встроенных векторах; тренировка определяет актуальные числа.)

Когда пример орабатывается, одна из categorical_column_with... функций картирует строку примера к числовому категориальному свойству. Например, функция картирует "spoon" к [32]. (32 мы просто придумали - актуальное значение зависит от картирующей функции.) Затем можно представить эти числовые категориальные свойства любым из следующих способов:

  • Как индикаторная колонка. Функция преобразует каждое числовое категориальное значение в 81-элементный вектор (поскольку мы ипользуем ограничение из 81 слова), размещая 1 для индекса категориального значения (0, 32, 79, 80) и 0 для всех остальных позиций.
  • Как встроенная колонка. Функция использует числовые категориальные значения (0, 32, 79, 80) как индексы в поисковой таблице. Каждый слот в этой поисковой таблице состоит из 3-элементного вектора.

Как значения во встроенных векторах назначаются? На самом деле назначения происходят в ходе тренировки. То есть модель обучается наилучшему способу картировать вводные числовые категориальные значения к значению встроенного вектора, чтобы решить задачу. Встроенные колонки увеличивают возможности модели, ввиду того, что встроенный вектор обучается новым взаимоотношениям между категориями из тренировочных данных.

Почему встроенный вектор имеет размер 3 в нашем примере? Следующая "формула" предоставляет общее правило насчет количества измерений во встроенном векторе:

embedding_dimensions =  number_of_categories**0.25

Ввиду того, что размер нашего словаря в этом примере 81, рекомендуемое количество измерений равно 3:

3 =  81**0.25

Отметим, что это только рекомендация, можно задавать количество встроенных измерений по своему желанию.

Вызываем tf.feature_column.embedding_column для создания embedding_column, как видно в следующем участке кода:

categorical_column = ... # Создаем любую категориальную колонку

# Представляем категориальную колонку как встроенную колонку.
# Это означает создание встроенного вектора поисковой таблицы 
# с одним элементом для каждой категории.
embedding_column = tf.feature_column.embedding_column(
    categorical_column=categorical_column,
    dimension=embedding_dimensions)

Как показывает следующий список, не все Estimators принимают все типы колонок свойств.

  • tf.estimator.LinearClassifier и tf.estimator.LinearRegressor: принимают все типы колонок свойств.
  • tf.estimator.DNNClassifier и tf.estimator.DNNRegressor: только тесносвязанные (dense) колонки. Другие типы колонок должны быть обернуты в indicator_column или embedding_column.
  • tf.estimator.DNNLinearCombinedClassifier и tf.estimator.DNNLinearCombinedRegressor:
    • linear_feature_columns аргумент принимает любые типы колонок свойств.
    • dnn_feature_columns принимают только тесносвязанные колонки.

четверг, 11 октября 2018 г.

TensorFlow Estimators: сохранение и восстановление моделей

В этом посте мы рассмотрим как сохранять и восстанавливать TensorFlow модели, построенные с Estimators. TensorFlow предоставляет два формата моделей:

  • Контрольные точки - это формат, зависимый от кода, создающего модель.
  • SavedModel - формат, независимый от кода, создающего модель.

В этом посте мы будем использовать формат контрольных точек.

Код примера

Мы будем использовать пример классификации ирисов из предыдущего поста. Чтобы загрузить этот пример выполните следующее:

git clone https://github.com/tensorflow/models/
cd models/samples/core/get_started

Большинство отрывков кода в этом посте - это минимальные вариации premade_estimator.py.

Сохранение частично-тренированных моделей.

Estimators автоматически записывают следующее на диск:

  • Контрольные точки - версии модели, созданные в ходе тренировки.
  • Файлы событий, содержащие информацию, которую использует TensorBoard для создания визуализаций.

Чтобы определить директорию верхнего уровня, в которую Estimator сохраняет эту информацию, назначим значение для опционального model_dir аргумента любого Estimator конструктора. Для DNNClassifier, например, следующий код устанавливает model_dir аргумент равным models/iris директории:

classifier = tf.estimator.DNNClassifier(
    feature_columns=my_feature_columns,
    hidden_units=[10, 10],
    n_classes=3,
    model_dir='models/iris')

Предположим был вызван train метод Estimator'а. Например:

classifier.train(
        input_fn=lambda:train_input_fn(train_x, train_y, batch_size=100),
                steps=200)

Как изображено на следующей диаграмме, первый вызов train добавляет контрольные точки и другие файлы в model_dir директорию:

Первый вызов train()


Чтобы увидеть объекты в созданной model_dir директории в системе UNIX семейства просто вызовете ls команду:

$ ls -1 models/iris
checkpoint
events.out.tfevents.timestamp.hostname
graph.pbtxt
model.ckpt-1.data-00000-of-00001
model.ckpt-1.index
model.ckpt-1.meta
model.ckpt-200.data-00000-of-00001
model.ckpt-200.index
model.ckpt-200.meta

Предыдущая ls команда показывает, что Estimator создал контрольные точки на шаге 1 (начало тренировки) и 200 (конец тренировки).

Директория контрольных точек по умолчанию

Если не определить model_dir в конструкторе Estimator'а, Estimator запишет файлы контрольной точки во временную директорию, выбранную Python tempfile.mkdtemp фукнцией. Например, следующий Estimator конструктор не определяет model_dir аргумент:

classifier = tf.estimator.DNNClassifier(
    feature_columns=my_feature_columns,
    hidden_units=[10, 10],
    n_classes=3)

print(classifier.model_dir)

tempfile.mkdtemp функция выбирает защищенную, временную директорию согласно операционной системе. Например, обычная временная директория для macOS может выглядеть примерно следующим образом:

/var/folders/0s/5q9kfzfj3gx2knj0vj8p68yc00dhcr/T/tmpYm1Rwa

Частота создания контрольных точек

По умолчанию, Estimator сохраняет контрольные точки в model_dir согласно следующему расписанию:

  • Записывает контрольную точку каждые 10 минут (600 секунд).
  • Записывает контрольную точку когда метод train начинается (первая итерация) и завершается (последняя итерация).
  • Оставляет только 5 наиболее недавних контрольных точек в директории.

Можно изменить расписание по умолчанию, выполнив следующие шаги:

  1. Создать tf.estimator.RunConfig объект, который определяет желаемое расписание.
  2. При создании инстанса Estimator передать этот RunConfig объект в качестве Estimator config аргумента.

Например, следующий код изменяет расписание создания контрольных точек - записывать каждые 20 минут и оставлять 10 последних контрольных точек:

my_checkpointing_config = tf.estimator.RunConfig(
    # Сохраняем контрольные точки каждые 20 минут
    save_checkpoints_secs = 20*60,  
    # Оставляем 10 последних контрольных точек
    keep_checkpoint_max = 10,       
)

classifier = tf.estimator.DNNClassifier(
    feature_columns=my_feature_columns,
    hidden_units=[10, 10],
    n_classes=3,
    model_dir='models/iris',
    config=my_checkpointing_config)

Восстановление модели

При первом вызове Estimator train метода, TensorFlow сохраняет контрольную точку в model_dir. Каждый последующий вызов Estimator train, evaluate, или predict метода вызывает следующее:

  1. Estimator строит граф модели, выполняя model_fn().
  2. Estimator инициализирует веса новой модели из данных сохраненных в наиболее недавней контрольной точке.

Другими словами, как показано на следующем графике, если контрольная точка существует TensorFlow перестраивает модель каждый раз когда вызывается train(), evaluate(), или predict().

Последовательные вызовы train(), evaluate(), или predict()


Как избежать ошибок при восстановлении.

Восстановление состояния модели из контрольной точки работает только если модель и контрольная точка совместимы. Например, возьмем тренировку DNNClassifier Estimator, содержащего два скрытых слоя, каждый имеющий 10 узлов:

classifier = tf.estimator.DNNClassifier(
    feature_columns=feature_columns,
    hidden_units=[10, 10],
    n_classes=3,
    model_dir='models/iris')

classifier.train(
    input_fn=lambda:train_input_fn(train_x, train_y, batch_size=100),
        steps=200)

После тренировки (и, следовательно, после создания контрольных точек в models/iris), представим, что было изменено количество нейронов в каждом скрытом слое с 10 на 20, и затем попытаемся восстановить модель:

classifier2 = tf.estimator.DNNClassifier(
    feature_columns=my_feature_columns,
    hidden_units=[20, 20],  # Изменяем количество нейронов в модели.
    n_classes=3,
    model_dir='models/iris')

classifier.train(
    input_fn=lambda:train_input_fn(train_x, train_y, batch_size=100),
        steps=200)

Ввиду того, что состояние в контрольной точки несовместимо с моделью, описанной в classifier2, повторная тренировка проваливается со следующей ошибкой:

...
InvalidArgumentError (see above for traceback): tensor_name =
dnn/hiddenlayer_1/bias/t_0/Adagrad; shape in shape_and_slice spec [10]
does not match the shape stored in checkpoint: [20]

Для выполнения экспериментов, в которых происходит тренировка и сравнение незначительно отличающихся версий модели, сохраняйте копии кода, каждая из которых создает свою model_dir, например, это возможно созданием отдельных git веток для каждой версии. Такое разделение сохранит контрольные точки восстанавливаемыми.

Резюме

Контрольные точки предоставляют простой автоматизированный метод для сохранения и восстановления моделей, созданных с помощью Estimators.

понедельник, 8 октября 2018 г.

TensorFlow Estimators: задача классификации Iris

В этом посте мы покажем решение классической задачи классификации Iris с помощью TensorFlow.

Предпосылки

Для использования примеров кода в этом руководстве необходимо следующее:

  • Установить TensorFlow
  • Если TensorFlow установлен вместе virtualenv или Anaconda, тогда необходимо активировать TensorFlow окружение.
  • Установить или обновить pandas, используя следующую команду:
  • pip install pandas
    

Получение кода из примеров

Для получения примеров кода в этом руководстве выполните следующее:

  1. Склонируйте TensorFlow Models репозиторий с GitHub следующей командой:

    git clone https://github.com/tensorflow/models
    

  2. Смените директорию в этой ветке на место, содержащее примеры:

    cd models/samples/core/get_started/
    

Программа, описанная в этом руководстве - это premade_estimator.py. Эта программа использует iris_data.py для получения тренировочных данных.

Выполнение программы

TensorFlow программы можно запускать как любые другие Python программы. Например:

python premade_estimator.py

Программа должна вывести тренировочные логи, затем прогнозы относительно тестового набора. Например, первая линия следующего вывода показывает, что модель оценила с 99.6% вероятностью, что первый пример в тестовом наборе - это вид Setosa. Ввиду того, что тестовый набор ожидал Setosa, этот прогноз верен.

...
Prediction is "Setosa" (99.6%), expected "Setosa"

Prediction is "Versicolor" (99.8%), expected "Versicolor"

Prediction is "Virginica" (97.9%), expected "Virginica"

Если программа выдала ошибку вместо ответов, необходимо проверить следующие пункты:

  • Правильно ли установлен TensorFlow?
  • Используется ли правильная версия TensorFlow? (использован 1.9)
  • Активировано ли окружение, в котором установлен TensorFlow? (если использовался virtualenv или Anaconda)

Программный стек

Перед углублением в детали самой программы рассмотрим программное окружение. На следующем графике показано, что TensorFlow предоставляет программный стек, состоящий из нескольких API слоев:

Рекомендуется писать TensorFlow программы со следующими API:

  • Estimators, которые представляют полностью готовые модели. Estimator API предоставляет методы для тренировки модели, оценки аккуратности модели и вывода прогнозов.
  • Datasets для Estimators, которые строят потоки вводных данных. Dataset API имеет методы для загрузки и манипулирования данными, и передачи их в модель. Dataset API тесно связано с Estimators API.

Классификация ирисов: обзор

Пример программы в этом руководстве создает и тестирует модель, которая классифицирует цветы Ириса на три разных вида, основываясь на размере их чашелистиков и лепестков.

Слева направо Iris setosa, Iris versicolor, Iris virginica.

Набор данных

Iris набор данных сожержит 4 свойства и одну метку. Четыре свойства идентифицируют ботанические характеристики цветов ириса:

  • длина чашелистика
  • ширина чашелистика
  • длина лепестка
  • ширина лепестка

Наша модель будет представлять эти свойства как нецельночисловые 32-битовые данные.

Метка идентифицирует вид Iris. один из следующих:

  • Iris setosa (0)
  • Iris versicolor (1)
  • Iris virginica (2)

Наша модель будет представлять метку как цельночисловые 32-битовые данные.

Следующая таблица показывает три примера в наборе данных:

Алгоритм

Программа тренирует модель классификатор глубокой нейронной сети (Deep Neural Network (DNN)), имеющую следующую топологию:

  • 2 скрытых слоя
  • каждый скрытый слой имеет 10 узлов (нод)

Следующий график иллюстрирует свойства, скрытые слои, прогнозы (не все узлы в скрытых слоях показаны):

Вывод

Выполнение тренированной модели на непомеченном примере выводит три прогноза, а именно вероятность того, что этот цветок является одним из трех видов ирисов. Сумма этих выведенных прогнозов равна 1. Например, прогноз для немеченного примера может быть похожим на следующий:

  • 0.03 для Iris Setosa
  • 0.95 для Iris Versicolor
  • 0.02 для Iris Virginica

Этот прогноз показывает, что с 95% вероятностью переданный пример является Iris Versicolor.

Обзор программирования с Estimators

Estimator - это TensorFlow высокоуровневое представление завершенной модели. Он управляет деталями инициализации, логированием, сохранением и восстановлением, и многими другими свойствами, так чтобы можно было сконцентрироваться на разработке самой модели.

Любой Estimator - это производный класс от tf.estimator.Estimator. TensorFlow предоставляет коллекцию tf.estimator (например, LinearRegressor) для реализации алгоритмов машинного обучения. Кроме того можно писать собственные кастомные Estimators. В первую очередь рекомендуется использовать предсозданные Estimators.

Для написания TensorFlow программы, основанной на предсозданных Estimators необходимо выполнить следующие шаги:

  • Создать одну или несколько функций ввода.
  • Определить колонки свойств модели.
  • Создать инстанс Estimator, задав колонки свойств и различные гиперпараметры.
  • Вызвать один или несколько методов на Estimator объекте, передав подходящую функцию ввода как источник данных.

Рассмотрим как эти шаги реализованы для Iris классификации.

Создание функций ввода

Необходимо создать функции ввода, чтобы передать данные для тренировки, оценки, и прогнозирования.

Функция ввода - это функция, которая возвращает tf.data.Dataset объект, который выводит следующий двухэлементный тапл (tuple):

  • features - это Python словарь в котором:
    • Каждый ключ - это имя свойства.
    • Каждое значение - это массив, содержащий все значения свойства.
  • label - это массив, содержащий значения метки для каждого примера.

Для демонстрации формата функции ввода, вот простой пример:

def input_evaluation_set():
    features = {'SepalLength': np.array([6.4, 5.0]),
                'SepalWidth':  np.array([2.8, 2.3]),
                'PetalLength': np.array([5.6, 3.3]),
                'PetalWidth':  np.array([2.2, 1.0])}
    labels = np.array([2, 1])
    return features, labels

Функция ввода может производить лист словаря свойств и метки любым предпочитаемым образом. Однако, рекомендуется использование TensorFlow Dataset API, которое может обрабатывать все виды данных. На высоком уровне Dataset API состоит из следующих классов:

Где отдельные участники это:

  • Dataset - основной класс, содержащий методы для создания и трансформирования датасетов. Также позволяет инициализировать датасет из данных в памяти, или из Python генератора.
  • TextLineDataset - читает строки из текстовых файлов.
  • TFRecordDataset - читает записи из TFRecord файлов.
  • FixedLengthRecordDataset - читает записи фиксированного размера из бинарных файлов.
  • Iterator - предоставляет путь для доступа к одному элементу набора данных за один раз.

Dataset API может обрабатывать большинство часто встречающихся случаев. Например, используя Dataset API, можно легко читать записи из большой коллекции файлов параллельно и объединять их в один поток.

Чтобы сохранить вещи простыми в этом примере загрузим данные с использованием pandas, и построим поток ввода из данных в памяти.

Вот функция ввода, использованная для тренировки в этой программе, которая доступна в iris_data.py:

def train_input_fn(features, labels, batch_size):
    """Функция ввода для тренировки"""
    # Преобразует вводы в Dataset.
    dataset = tf.data.Dataset.from_tensor_slices(
                                (dict(features), labels))

    # Перемешивание, повтор, и пакетизация примеров.
    return dataset.shuffle(1000).repeat().batch(batch_size)

Определение колонок свойств

Колонка свойства - это объект, описывающий как модель должна использовать сырые данные ввода из словаря свойств. При создании Estimator модели передается лист колонок свойств, который описывает каждое свойство, которое будет использовать модель. tf.feature_column модуль предоставляет много настроек для представления данных модели.

Для Iris примера, 4 сырых свойства - это числовые значения, поэтому строим лист колонок свойств информируя Estimator модель представлять каждое и четырех свойств как 32-битные нецельночисловые значения. Вот код для создание колонки свойств:

# Колонки свойств описывают как использовать ввод
my_feature_columns = []
for key in train_x.keys():
    my_feature_columns.append(tf.feature_column.numeric_column(key=key))

Колонки свойств могут быть намного более сложными, чем показано в примере выше.

Теперь, когда есть описание того как модель должна представлять сырые свойства, можно построить estimator.

Создание инстанса estimator

Iris задача - это классическая задача классификации. К счастью, TensorFlow предоставляет несколько предсозданных Estimators классификаторов, включая:

  • tf.estimator.DNNClassifier для глубоких моделей, которые выполняют мультиклассовую классификацию.
  • tf.estimator.DNNLinearCombinedClassifier для широких и глубоких моделей.
  • tf.estimator.LinearClassifier для классификаторов, основанных на линейных моделях.

Для Iris задачи, tf.estimator.DNNClassifier подходит лучше всего. Вот создание инстанса этого Estimator:

# Строим DNN с 2 скрытыми слоями и 10 узлами в каждом скрытом слое.
classifier = tf.estimator.DNNClassifier(
    feature_columns=my_feature_columns,
    # Два скрытых слоя из 10 узлов каждый.
    hidden_units=[10, 10],
    # Модель должна делать выбор из 3 классов.
    n_classes=3)

Тренировка, оценка, и прогнозирование.

Теперь, когда у нас есть Estimator объект, можно вызывать методы, выполняющие следующее:

  • Тренируют модель.
  • Оценивают тренированную модель.
  • Используют тренированную модель для выполнения прогнозов.

Тренировка модели.

Тренируем модель, вызывая тренировочный метод Estimator'а:

# Тренируем модель.
classifier.train(
    input_fn=lambda:iris_data.train_input_fn(
                            train_x, train_y, args.batch_size),
    steps=args.train_steps)

Здесь мы обернули input_fn вызов в лямбда для захвата аргументов, предоставляя функцию ввода, которая не принимает аргументов, как ожидает Estimator. Аргумент steps сообщает методу остановить тренировку после ряда тренировочных шагов.

Оценка тренированной модели.

Теперь модель натренирована и можно получить статистику ее производительности. Следующий код оценивает аккуратность тренированной модели на тестовых данных:

# Оцениваем модель.
eval_result = classifier.evaluate(
    input_fn=lambda:iris_data.eval_input_fn(
                                    test_x, test_y, args.batch_size))

print('\nTest set accuracy: {accuracy:0.3f}\n'.format(**eval_result))

В отличие от вызова метода тренировки, мы не передаем steps аргумент для оценки. eval_input_fn выводит только единственную эпоху данных.

Выполнение кода выше выводит следующий результат:

Test set accuracy: 0.967

eval_result словарь также содержит average_loss (среднюю потерю на пример), loss (среднюю потрею на мини-пакет) и значение global_step estimator'а (количество тренировочных итераций, которые были проведены).

Выполнение прогнозов (вывод) на тренированной модели.

Теперь у нас есть тренированная модель, которая производит хорошие результаты. Можно использовать тренированную модель для прогнозирования видов цветов ириса, основываясь на немеченных измерениях. Как и с тренировкой и оценкой, выполняем прогнозирование, используя единственный вызов функции:

# Генерируем прогнозы на модели 
expected = ['Setosa', 'Versicolor', 'Virginica']
predict_x = {
    'SepalLength': [5.1, 5.9, 6.9],
    'SepalWidth': [3.3, 3.0, 3.1],
    'PetalLength': [1.7, 4.2, 5.4],
    'PetalWidth': [0.5, 1.5, 2.1],
}

predictions = classifier.predict(
    input_fn=lambda:iris_data.eval_input_fn(predict_x,
                                            batch_size=args.batch_size))

predict метод возвращает python итерируемый объект, выводящий словарь результатов прогноза для каждого примера. Следующий код печатает несколько прогнозов и их вероятности:

template = ('\nPrediction is "{}" ({:.1f}%), expected "{}"')

for pred_dict, expec in zip(predictions, expected):
    class_id = pred_dict['class_ids'][0]
    probability = pred_dict['probabilities'][class_id]

    print(template.format(iris_data.SPECIES[class_id],
                          100 * probability, expec))

Выполнение предыдущего кода дает следующий вывод:

...
Prediction is "Setosa" (99.6%), expected "Setosa"

Prediction is "Versicolor" (99.8%), expected "Versicolor"

Prediction is "Virginica" (97.9%), expected "Virginica"

Резюме

Предсозданные Estimators - это эффективный путь для быстрого создания стандартных моделей.

среда, 3 октября 2018 г.

TensorFlow: введение в Estimators API

В этом посте мы кратко осветим tf.estimator (оценщик) - высокоуровневое TensorFlow API, которое значительно упрощает программирование машинного обучения. Estimators заключают в себе следующие действия:

  • тренировка
  • оценка
  • прогнозирование
  • экспорт для сохранения

Можно использовать предсозданные Estimators либо писать собственные кастомные Estimators. Все Estimators - предсозданные или кастомные - это классы, основанные на tf.estimator.Estimator классе.

Преимущества использования Estimators

Estimators предоставляют следующие преимущества:

  • Можно исполнять, основанные на Estimators, модели на локальном хосте или в распределенном мульти-серверном окружении без изменения модели. Более того, можно исполнять, основанные на Estimators, модели на CPU, GPU, или TPU без записи модели.
  • Estimators упрощают обмен реализациями между разработчиками моделей.
  • Можно разрабатывать модели, реализующие самые последние достижения, с высокоуровневым интуитивно понятным кодом. Вкратце, намного проще создавать модели с Estimators, чем с низкоуровневыми TensorFlow API.
  • Estimators сами постороены на tf.keras.layers, которые упрощают кастомизацию.
  • Estimators сами создают графы.
  • Estimators предоставляют безопасный распределенный тренировочный цикл, который контролирует как и когда:
    • постороить граф
    • инициализировать переменные
    • загружать данные
    • обрабатывать исключения
    • создавать файлы контрольных точек и восстанавливать при провалах
    • сохранять резюме для TensorBoard

При написании приложения с Estimators необходимо разделять пайплайн ввода данных от модели. Такое разделение упрощает эксперименты с различными наборами данных.

Предсозданные Estimators

Предсозданные Estimators позволяют работать на более высоком концептуальном уровне, чем основные TensorFlow API. Больше не нужно беспокоиться о создании вычислительного графа или сессий, поскольку Estimators делают все это сами. То есть предсозданный Estimator создает и управляет tf.Graph и tf.Session объектами. Более того предсозданные Estimators позволяют экспериментировать с различными архитектурами моделей, выполняя только минимальные изменения в коде. tf.estimator.DNNClassifier, например, - это предсозданный Estimator класс, который тренирует классификационные модели, основанные на тесносвязанных, опережающих нейронных сетях.

Структура программы предсозданных Estimators

TensorFlow программа основанная на предсозданном Estimator обычно состоит из четырех этапов:

  1. Запись одной или нескольких функций импортирования набора данных. Например, можно создать одну функцию для импорта тренировочного набора и другую функцию для импорта тестового набора. Каждая функция импортирования набора данных должна возвращать два объекта:

    • словарь, в котором ключи - это имена свойств, а значения - это Tensors (или SparseTensors), содержащие соответствующие данные свойств
    • Tensor, содержащий одну или несколько меток

    Например, следующий код иллюстрирует основной скелет для функции ввода:

    def input_fn(dataset):
       # манипулирование датасетом, извлечение словаря свойств и метки
       ...  
       return feature_dict, label
    

  2. Определение колонок свойств. Каждый tf.feature_column идентифицирует имя свойства, его тип, и любую предобработку ввода. Например, следующий код создает три колонки свойств, которые хранят цельночисловые или нецельночисловые данные. Первые две колонки свойств просто идентифицируют имя свойства и тип. Третья колонка свойства также определяет лямбда программу, которая будет вызываться для масштабирования сырых данных:

    # Определяем три числовые колонки свойств.
    population = tf.feature_column.numeric_column('population')
    crime_rate = tf.feature_column.numeric_column('crime_rate')
    median_education = tf.feature_column.numeric_column(
                   'median_education',
                   normalizer_fn=lambda x: x - global_education_mean)
    

  3. Создание инстанса соответствующего предсозданного Estimator. Например, вот пример создания инстанса предсозданного Estimator, называющегося LinearClassifier:

    # Создаем инстанс оценщика (estimator), передавая колонки свойств
    estimator = tf.estimator.LinearClassifier(
        feature_columns=[population, crime_rate, median_education],
        )
    

  4. Вызов метода тренировки, оценки, или вывода (метод производственного использования). Например, все Estimators предоставляют тренировочный метод, который тренирует модель.

    # my_training_set - это функция, созданная на первом шаге
    estimator.train(input_fn=my_training_set, steps=2000)
    

Преимущества предсозданных Estimators

Предсозданные Estimators воплощают лучшие практики, предоставляя следующие преимущества:

  • Лучшие практики для определения того, где различные части вычислительного графа должны выполняться, воплощая исполнение на одной машине или в кластере
  • Лучшие практики для записи отдельных событий (резюме) и универсально полезных резюме

Если не использовать Estimators, то необходимо самому реализовывать все вышеперечисленное.

Кастомные Estimators

Сердце любого Estimator - предсозданного или кастомного - это функция модели, которая представляет собой метод, который строит граф для тренировки, оценки, и прогнозирования. При использовании предсозданного Estimator, задействуется уже реализованная функция модели. При использовании кастомного Estimator необходимо самому писать функцию модели.

Рекомендуемый рабочий поток

Рекомендуется использовать следующий рабочий поток:

  1. Предположим подходящий предсозданный Estimator существует - используем его для построения первой модели и используем ее результаты для определения базовой линии.
  2. Создаем и тестируем весь пайплайн, включая целостность и надежность данных с этим предсозданным Estimator.
  3. Если доступны подходящие альтернативные предсозданные Estimators, тогда выполняем эксперименты для определения, который предсозданный Estimator производит лучшие результаты.
  4. Возможно дальше улучшаем модель, строя собственный кастомный Estimator.

Создание Estimators из Keras моделей

Можно конвертировать существующие Keras модели в Estimators. Это позволяет Keras модели получить доступ к преимуществам Estimator, таким как распределенная тренировка. Вызываем tf.keras.estimator.model_to_estimator как в следующем примере:

# Создаем инстанс Keras inception v3 модели
keras_inception_v3 = \ 
  tf.keras.applications.inception_v3.InceptionV3(weights=None)

# Компилируем модель с оптимизатором, функцией потери, 
# и метриками, которые необходимы для тренировки
keras_inception_v3.compile(optimizer=tf.keras.optimizers.SGD(
                               lr=0.0001, momentum=0.9),
                          loss='categorical_crossentropy',
                          metric='accuracy')

# Создаем Estimator из компилированной Keras модели.
# Следует отметить, что состояние первоначальной keras модели
# сохраняется в созданном Estimator.
est_inception_v3 = tf.keras.estimator.model_to_estimator(
                              keras_model=keras_inception_v3)

# Используем произведенный Estimator как любой другой Estimator.
# Во-первых, восстанавливаем имя(имена) ввода Keras модели,
# так мы можем использовать их как имя(имена) колонок свойств
# фунции ввода Estimator:
keras_inception_v3.input_names  # выдает: ['input_1']

# Как только у нас есть имя(имена) ввода, 
# мы можем создать функцию ввода,
# например, для ввода в формате numpy ndarray:
train_input_fn = tf.estimator.inputs.numpy_input_fn(
    x={"input_1": train_data},
    y=train_labels,
    num_epochs=1,
    shuffle=False)

# Для тренировки вызываем функцию тренировки Estimator:
est_inception_v3.train(input_fn=train_input_fn, steps=2000)

Следует отметить, что имена колонок свойств и метки keras estimator приходят из соотвествующей скомпилированной keras модели. Например, ключи имен ввода для train_input_fn выше могут быть получены из keras_inception_v3.input_names, и аналогично, прогнозируемые выводные имена могут быть получены из keras_inception_v3.output_names.

Подробней о TensorFlow Estimators читайте в последующих постах.